 본문으로 건너뛰기
고등학교 때 저는 방송반이었습니다.
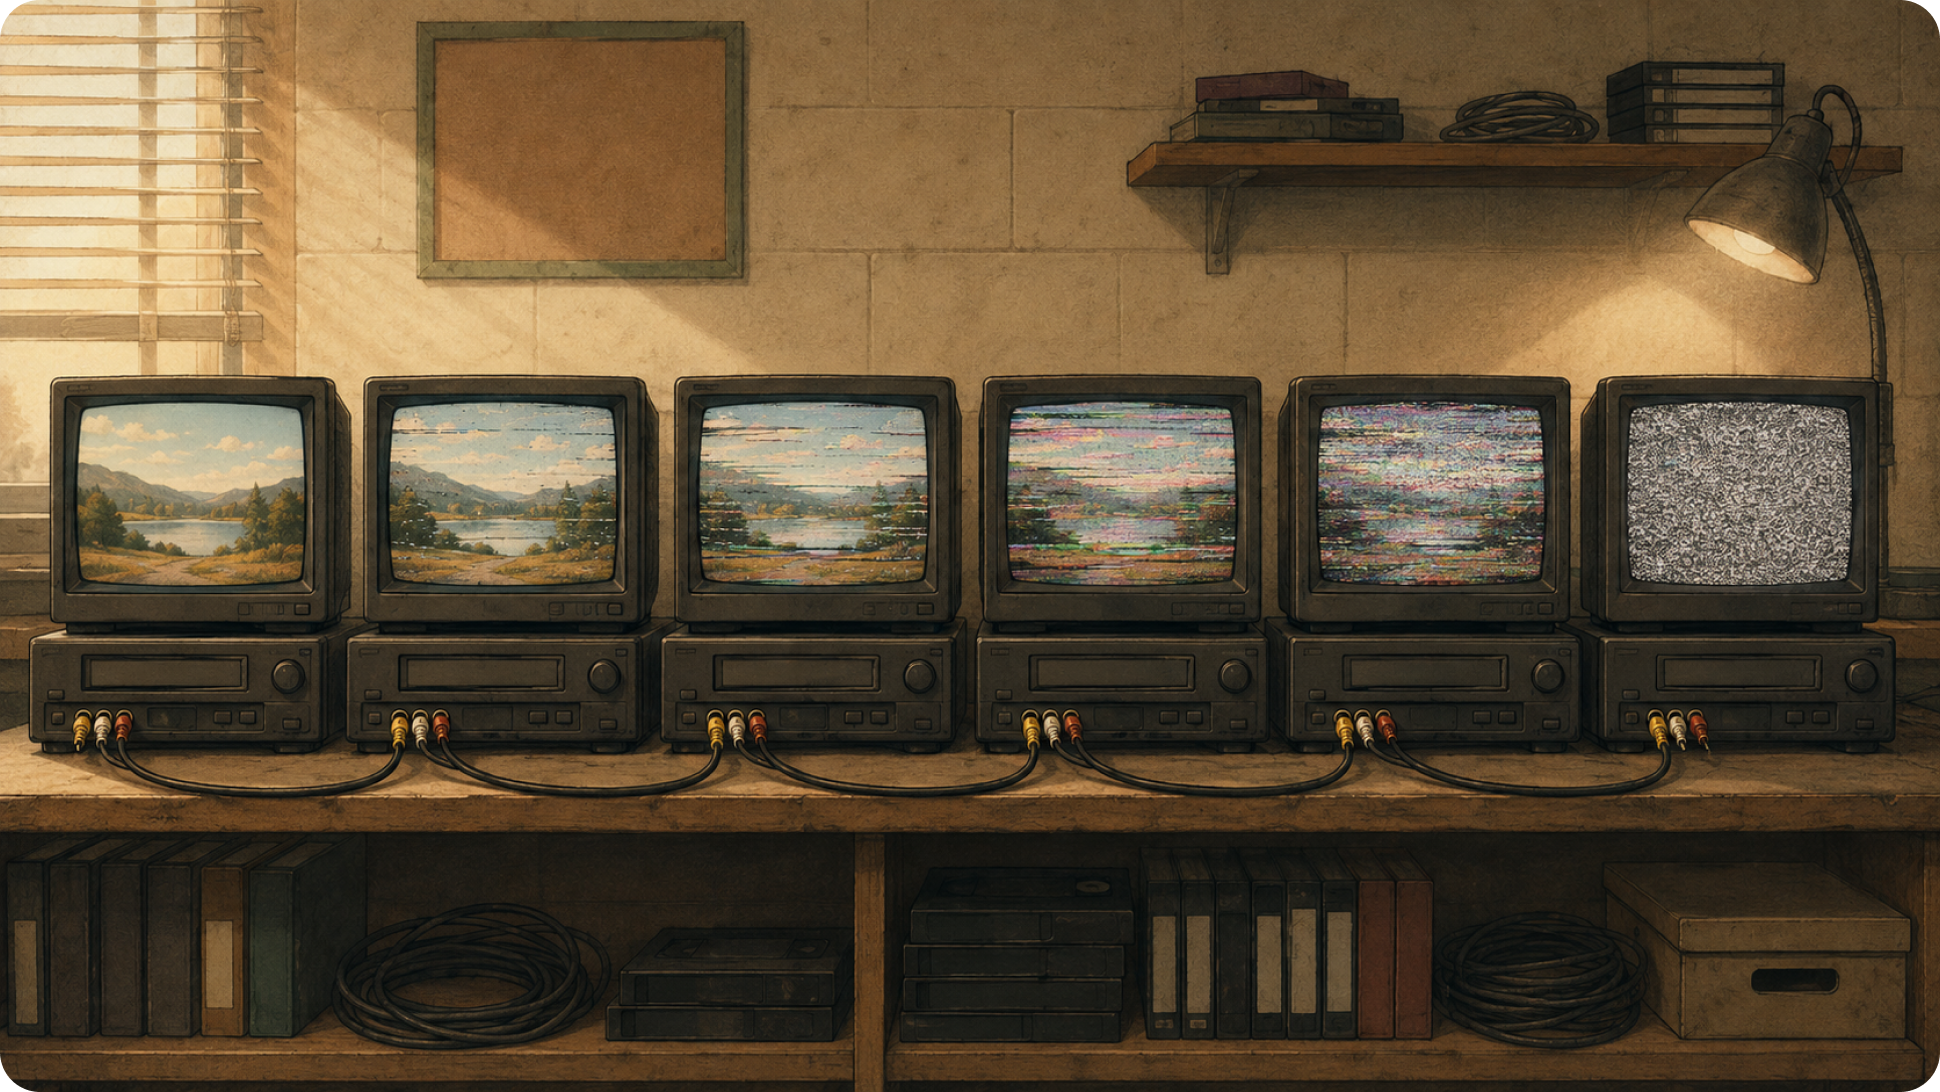
그때는 비디오테이프 시절이라 영상 하나를 여러 개로 복사해야 하는 일이 종종 있었습니다. 열 개를 만들어야 하는 날도 있었죠. 데크 한 대로 하나씩 뜨면 같은 작업을 열 번 반복해야 합니다.
그래서 저는 꾀를 냈습니다. 방송반 데크에는 입력과 출력이 따로 있었는데, 1번 데크의 출력을 2번 데크의 입력에 꽂고, 2번의 출력을 다시 3번의 입력에 꽂았습니다. 그렇게 열 대를 줄줄이 이어 놓고 한 번에 녹화 버튼을 눌렀습니다. 열 번 걸릴 일을 한 번에 끝낼 생각이었죠.
결과는 충격적이었습니다.
1번과 2번은 볼 만했습니다. 그런데 3번째 데크에 걸린 테이프부터는 도저히 봐줄 수가 없었어요. 뒤로 갈수록 노이즈가 조금씩 쌓이더니, 마지막 테이프는 무엇을 찍은 영상인지도 알 수 없는 지지직거리는 화면뿐이었습니다.
복사본을 복사하면 원본에서 멀어집니다. 아날로그에서는 이걸 세대 손실이라고 부릅니다. 한 세대마다 아주 조금씩 나빠지는데, 한 번에는 티가 안 나고 서너 번 쌓이면 눈에 보입니다.
그런데 그때 제가 운이 좋았던 게 하나 있습니다.
지지직거려서, 눈에 보였다는 것입니다. 저는 3번 테이프를 확인하자마자 전부 멈추고 처음부터 다시 했습니다. 화면이 저 대신 알려준 셈이죠.
그런데 문제는 완벽하지는 않지만 좋은 결과를 만드는 AI입니다. AI는 (2~3번 만에) 지지직거리지 않습니다. 세 번째 복사본도 여전히 매끄럽고, 문장은 단정하고, 결과는 그럴듯합니다. 하지만 그 사이 노이즈는 아주 조금씩 쌓이죠. 다만 우리 눈에 당장에 안보일 뿐이죠.
그래서 처음 받은 초안은 꽤 괜찮았는데, 몇 번 고쳐달라고 주고받다 보니 어느 순간 처음보다 뭔가 이상해진 결과가 나타납니다. 어디서부터 나빠졌는지는 알 수 없을 만큼 말이죠.
ChatGPT 생성 이미지
0.99를 365번 곱하면 0.026이 됩니다
한 번쯤 보셨을 그림입니다. 보통은 위쪽 줄을 말하려고 씁니다. 매일 1%씩 나아지면 1년 뒤에 37배가 된다는 이야기죠.
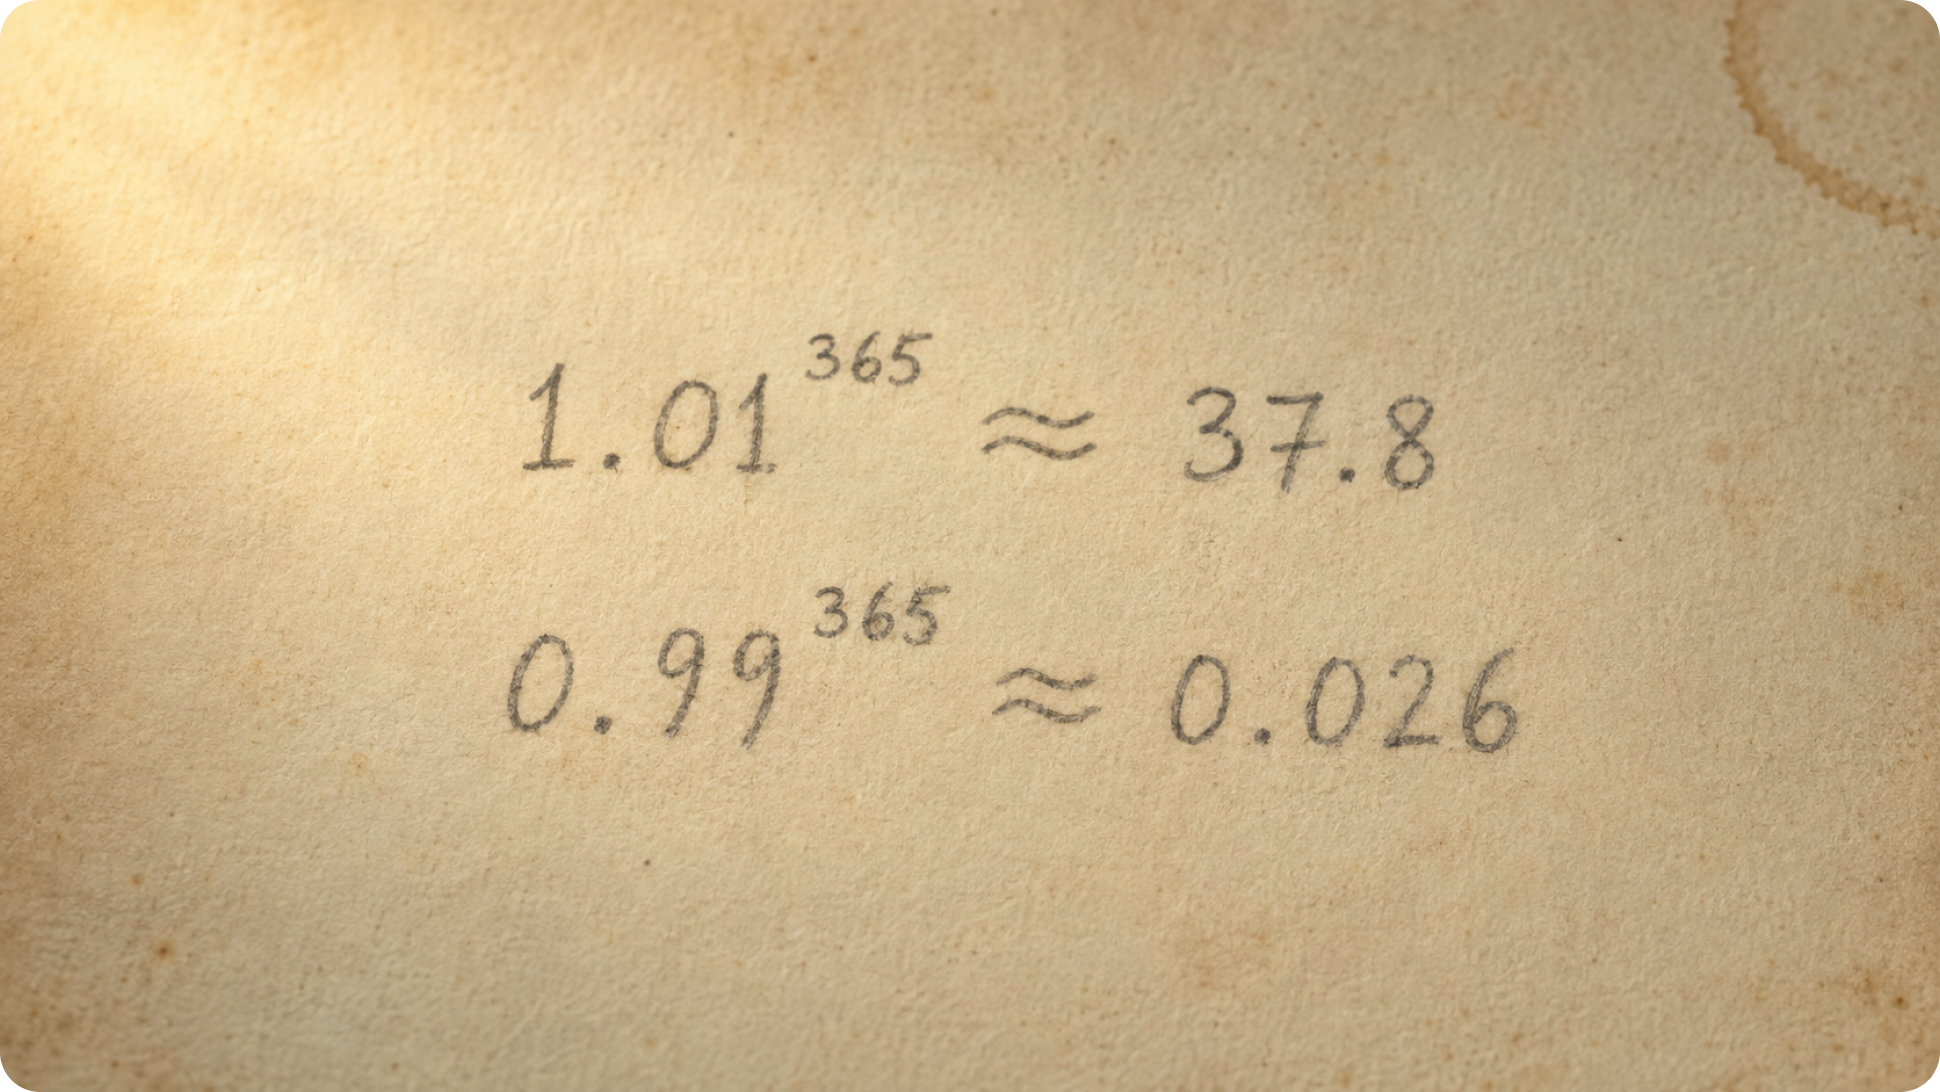
ChatGPT 생성 이미지
저는 오늘 아래쪽 줄을 이야기하려고 합니다. 매일 1%씩 나빠지면 1년 뒤에는 0.026이 됩니다. 2.6%가 아니라, 원래 있던 것의 40분의 1만 남는다는 뜻입니다.
1%는 아무것도 아닌 것처럼 보입니다. 그게 함정입니다. 한 번의 1%는 무시해도 되는 크기이고, 무시해도 되니까 실제로 무시합니다. 그리고 무시한 1%는 사라지지 않고 다음 회차의 출발점이 됩니다.
여기에 숫자를 조금 더 붙여보겠습니다.
3%씩 놓치면 → 10회 뒤 74%
5%씩 놓치면 → 10회 뒤 60%
1%씩 놓치면 → 100회 뒤 37%
AI와 문서 하나를 열 번 주고받는 일은 흔합니다. 저는 지침 하나를 스무 번 넘게 고칠 때도 있습니다.
20% 틀리면 고칩니다. 3% 틀리면 안 고칩니다
여기서 이상한 일이 벌어집니다. AI가 나빠져서 결과물이 나빠지는 게 아니라, AI가 좋아졌기 때문에 결과물이 나빠집니다.
2년 전 AI는 결과물의 10%, 20%가 이상했습니다. 요약이 어색하고, 없는 사실을 만들어내고, 코드는 실행조차 안 됐죠. 그러면 저는 무조건 열어봤습니다. 원문을 다시 확인하고, 문장을 직접 고치고, 직접 검색해서 확인했습니다. AI를 안 믿었으니까요.
지금은 3%, 5%만 이상합니다.
그런데 이 3%는 20%와 성질이 다릅니다. 20%는 읽자마자 눈에 띕니다. 3%는 읽어도 모릅니다. 문장은 매끄럽고 형식은 완벽하고 논리도 대체로 맞기 때문입니다. 틀린 부분만 조용히 아주 조금 틀려 있습니다.
그래서 우리는 고치지 않고 넘어갑니다. 정확히는 고칠 것이 없다고 판단하고 넘어가죠.
이건 결코 게을러서가 아닙니다. 사람의 주의력은 원래 그렇게 배분됩니다. 인간공학에서는 이걸 자동화 안일성이라고 부르는데, 파라수라만과 만체이가 2010년에 정리한 이 분야의 정본 논문은 안일성이 성격 결함도 훈련 부족도 아니라고 말합니다. 주의 자원을 나눠 쓰는 방식의 구조적 결과라는 겁니다. 초보자에게도 전문가에게도 똑같이 나타나고, 반복 연습한다고 없어지지도 않습니다. 그리고 손이 바쁠수록 더 심해진다고 합니다.
사람들은 "믿는다"고 말한 적이 없습니다. 그냥 덜 열어봤습니다
이걸 생각이 아니라 행동으로 잡아낸 실험이 있습니다. 바너와 만체이 연구팀이 2008년에 시도했는데요, 실험 장면이 꽤 구체적이라 그대로 옮겨보겠습니다.
참가자 24명에게 공장 설비를 감시하는 모의 시스템을 맡깁니다. 설비에 이상이 생기면 자동 진단 장치가 "지금 문제는 이겁니다"라고 원인을 짚어줍니다. 참가자는 그 진단을 받아서 조치를 하면 됩니다. 그런데 이 장치는 완벽하지 않아서 가끔 틀린 진단을 내놓습니다.
중요한 건 참가자에게 확인할 수단이 전부 주어져 있었다는 것입니다. 화면에는 시스템 상태를 보여주는 지표가 여러 개 붙어 있었고, 참가자는 아무 때나 원하는 만큼 열어볼 수 있었습니다. 몇 개만 확인하면 자동 진단이 맞는지 틀렸는지 그 자리에서 알 수 있었죠.
연구진이 센 것이 바로 그겁니다. 참가자가 지표를 실제로 몇 개나 열어봤는가.
결과는 이랬습니다. 장치가 잘 동작하는 것을 눈으로 볼수록 참가자가 직접 눈으로 확인하는 횟수는 점점 줄었습니다. 그리고 어느 순간부터는 장치가 틀린 진단을 내놓아도 참가자들은 그 진단을 그대로 따라갔습니다. 확인을 안 했으니 틀렸다는 걸 알 방법이 없었던 것이죠.
여기서 제일 무서운 대목은 따로 있습니다. 참가자 중 누구도 "이제 이 장치를 믿겠습니다"라고 결심한 적이 없다는 것입니다. 신뢰는 마음속에서 선언되지 않았습니다. 다만 열어보는 횟수가 조용히 줄어들었을 뿐입니다.
우리가 AI를 대하는 방식이 정확히 이렇습니다. 우리는 "이제 검토 안 할래"라고 결정한 적이 없습니다. 그냥 어느 순간부터 원문을 덜 열어보고 있을 뿐이죠. 그리고 그건 결정이 아니라서, 되돌아볼 계기도 생기지 않습니다.
그럼 몇 %부터 안 열어보게 될까요. 위켄스와 딕슨이 2007년에 연구 20편을 종합한 결과, 신뢰도 0.70 즉 70%가 교차점입니다. 이 아래면 사람은 자동화를 못 미더워하고, 이 위로 올라가면 자신도 모르게 기대기 시작합니다.
그러니까 95%짜리 AI는 안심이 되는 수치 정도가 아니라 이미 의심을 멈추는 선이 된 것이죠.